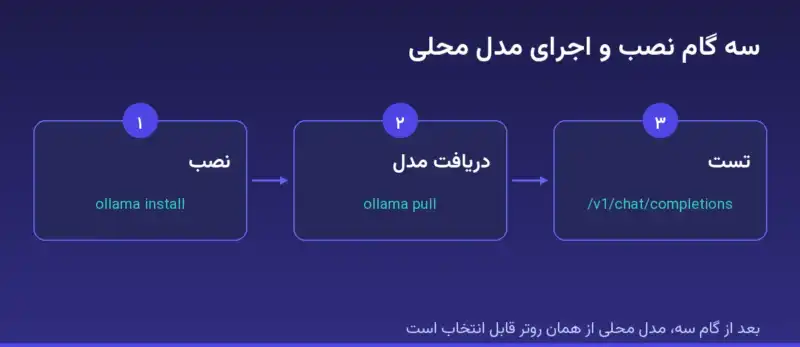
اگر نه اعتبار API میخواهید و نه کارت بانکی، تنها راه باقیمانده اجرای مدل روی سیستم خودتان است. Ollama این کار را روی ویندوز به یک دستور کاهش میدهد. در این راهنما از نصب تا وصل کردنش به 9Router و ابزارهای کدنویسی پیش میرویم، و صریح میگوییم کدام عدد از اجرای خودمان آمده و کدام از مستندات.
Ollama چیست و چه زمانی مدل محلی بهتر از API است
Ollama یک اجراکنندهٔ مدل است: وزنهای مدل را دانلود میکند، روی سختافزار شما بالا میآورد و یک API محلی روی آن میگذارد. برنامههای دیگر با همان API صحبت میکنند، دقیقاً مثل وقتی به یک سرویس ابری وصل میشوند.
سه موقعیت که مدل محلی برنده است:
- دادهٔ حساس. وقتی متن نباید از سیستم خارج شود، مدل محلی تنها گزینهٔ واقعی است.
- کار پرتکرار و کمارزش. برای دستهبندی هزار ردیف یا خلاصهسازی کوتاه، هزینهٔ هر درخواست صفر میشود.
- اتصال ضعیف. وقتی شبکه قطع و وصل میشود، مدلی که روی دیسک شماست همیشه در دسترس است.
و سه موقعیتی که مدل محلی بازنده است: استدلال پیچیده، کدنویسی روی پروژهٔ بزرگ، و هر کاری که کیفیت خروجی مهمتر از هزینه است. مدلهای کوچکی که روی لپتاپ بالا میآیند، در این سه مورد از مدلهای بزرگ عقبترند.
یک قاعدهٔ عملی برای انتخاب: اگر خروجی را میتوانید در یک نگاه تأیید یا رد کنید، مدل محلی کافی است. اگر باید خروجی را با دقت بخوانید و اصلاح کنید، مدل بزرگتر ارزانتر تمام میشود، چون وقت شما گرانتر از توکن است.
پیشنیازهای اجرای مدل محلی روی ویندوز
پیشنیاز اصلی، حافظه است. پردازندهٔ گرافیکی سرعت را بالا میبرد، اما نبودنش مانع اجرا نیست؛ مدل روی پردازنده هم بالا میآید، فقط کندتر.
حداقلهای عملی:
- رم: ۸ گیگ برای مدلهای کوچک کافی است، ۱۶ گیگ راحتتر، ۳۲ گیگ برای مدلهای بزرگتر.
- فضای دیسک: هر مدل بین چند گیگ تا چند ده گیگ. قبل از دانلود، فضا را ببینید.
- کارت گرافیک: اختیاری ولی مؤثر. اگر کارت دارید، درایور بهروز لازم است.
- ویندوز: نسخهٔ ۶۴ بیتی. نسخهٔ ۳۲ بیتی پشتیبانی نمیشود.
حداقل سختافزار برای اجرای مدل محلی: رم ۸ گیگابایت برای مدلهای ۳B تا ۴B، رم ۱۶ گیگابایت برای ۷B تا ۸B، و ۳۲ گیگابایت برای مدلهای بزرگتر. کارت گرافیک الزامی نیست، ولی اجرا روی CPU چند برابر کندتر است؛ اگر کارت دارید، درایور بهروز لازم است.
دربارهٔ فضای دیسک یک محاسبهٔ ساده کمک میکند: هر مدل، یک فایل وزن دارد که اندازهاش با تعداد پارامتر و نوع کوانتیزهسازی تعیین میشود. قبل از دانلود، به فهرست مدلهای نصبشده نگاه کنید و ببینید چقدر فضا مصرف شده؛ همان نسبت را برای مدل بعدی در نظر بگیرید. پر شدن دیسک در میانهٔ دانلود، خطای ناخوشایندی میدهد که دلیلش در پیام نیست.
نصب Ollama روی ویندوز قدم به قدم
- از سایت رسمی، نصبکنندهٔ ویندوز را دانلود کنید.
- فایل نصب را اجرا کنید و مسیر پیشفرض را نگه دارید.
- پس از نصب، یک پنجرهٔ خط فرمان تازه باز کنید.
- با دستور زیر بررسی کنید که سرویس در دسترس است:
ollama --versionخروجی مورد انتظار: یک شمارهٔ نسخه. اگر «is not recognized» دیدید، پنجرهٔ خط فرمان را ببندید و باز کنید یا سیستم را یک بار ریاستارت کنید تا مسیر در PATH بهروز شود.
سرویس بهطور پیشفرض در پسزمینه بالا میآید و روی آدرس زیر گوش میدهد:
http://localhost:11434برای دیدن فهرست مدلهای نصبشده:
ollama listخروجی مورد انتظار: جدولی با ستونهای نام، شناسه، اندازه و زمان. اگر خالی بود، یعنی هنوز مدلی دانلود نکردهاید و این طبیعی است.
اگر نصب کامل شد ولی سرویس پاسخ نداد، دو چیز را بررسی کنید. اول، در نوار وظیفه ببینید آیکن Ollama حاضر است؛ بعضی نسخهها سرویس را فقط پس از ورود کاربر بالا میآورند. دوم، یک بار ollama serve را در پنجرهٔ خط فرمان اجرا کنید و پیام خروجی را بخوانید؛ همان پیام معمولاً میگوید مشکل پورت است یا مشکل مسیر فایل مدلها.
انتخاب مدل: کدام مدل با چه مقدار رم بالا میآید
عدد کنار نام مدل (مثل 7B یا 13B) تعداد پارامترهاست. مدل بزرگتر معمولاً بهتر جواب میدهد و بیشتر حافظه میخواهد. جدول زیر راهنمای تقریبی است، نه قانون قطعی: کوانتیزهسازی، طول پرامپت و کارت گرافیک هم اثر دارند.
| رم | مدل پیشنهادی | تجربهٔ مورد انتظار |
|---|---|---|
| ۸ گیگابایت | مدلهای ۳B تا ۴B | کارهای سبک روان؛ مدل ۷B اجرا میشود ولی کند و با تعویض حافظه |
| ۱۶ گیگابایت | مدلهای ۷B تا ۹B | ردهٔ راحت روزمره: نوشتن، خلاصه، دستهبندی |
| ۳۲ گیگابایت | مدلهای ۱۳B تا ۳۴B با کوانتیزهٔ سبک | استدلال بهتر؛ سرعت به کارت گرافیک وابسته میشود |
نام دقیق تگها را از کتابخانهٔ خود Ollama بردارید؛ تگها و نسخهها مرتب عوض میشوند و نامی که در یک آموزش قدیمی دیدهاید ممکن است حذف شده باشد.
دربارهٔ کوانتیزهسازی یک نکتهٔ کافی: نسخههای فشردهشدهٔ یک مدل، حجم و حافظهٔ کمتری میخواهند و در عوض کمی از کیفیت را از دست میدهند. برای اکثر کارهای روزمره این معامله به سود شماست؛ برای کارهای حساس، نسخهٔ باکیفیتتر را انتخاب کنید و بپذیرید که کندتر است.
یک اشتباه رایج در انتخاب مدل: مقایسه بر پایهٔ تعداد پارامتر. مدل ۷B جدید میتواند از مدل ۱۳B قدیمی بهتر جواب بدهد. تاریخ انتشار و دادهٔ آموزشی مهمتر از اندازه است.
اجرای اولین مدل و تست سرعت روی سیستم خودتان
یک مدل کوچک بردارید تا اولین تجربه سریع باشد:
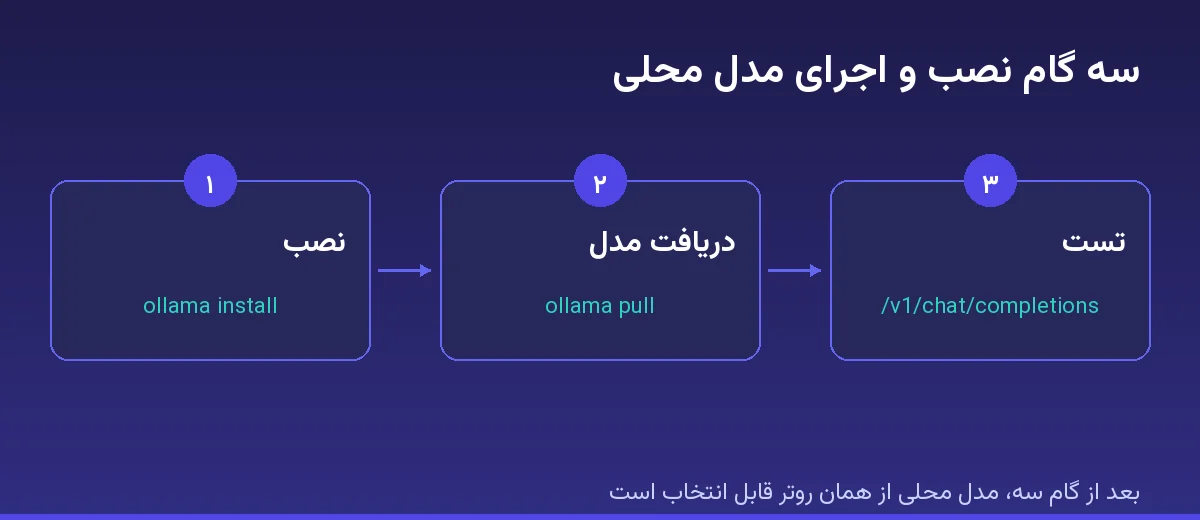
ollama pull llama3.2:3b
ollama run llama3.2:3b
خروجی مورد انتظار: دستور اول نوار دانلود نشان میدهد و در پایان موفقیت را اعلام میکند؛ دستور دوم یک خط فرمان گفتوگو باز میکند و آمادهٔ گرفتن پرامپت است.
برای سنجش سرعت روی سختافزار خودتان، یک پرامپت ثابت بدهید و زمان پاسخ را بگیرید. تمرین عملی این است که یک پرامپت مشخص را سه بار اجرا کنید و میانگین بگیرید؛ عدد یک اجرا در این کار بیمعنی است.
یک بنچمارک سادهٔ محلی که در ویندوز جواب میدهد:
Measure-Command {
  ollama run llama3.2:3b "یک پاراگراف کوتاه دربارهٔ کش لبه بنویس"
}
خروجی مورد انتظار: در پایان، زمان کل اجرای دستور چاپ میشود. همین عدد را برای مدلهای مختلف تکرار کنید تا بفهمید کدام مدل روی سیستم شما قابل استفاده است — نه اینکه در جدول اینترنت چه نوشتهاند.
سه عدد را جدا ثبت کنید تا مقایسه معنا پیدا کند: زمان تا اولین کلمه، زمان کل پاسخ، و تعداد کلمههای خروجی. اگر فقط زمان کل را بگیرید، مدلی که پاسخ بلندتری میدهد کندتر به نظر میرسد، حتی اگر در واقع سریعتر باشد.
پرامپت آزمون را عوض نکنید. اگر برای هر مدل سؤال متفاوتی بپرسید، اعداد قابل مقایسه نیستند. یک سؤال ثابت، سه اجرا، و میانگین؛ همین برای تصمیمگیری کافی است.
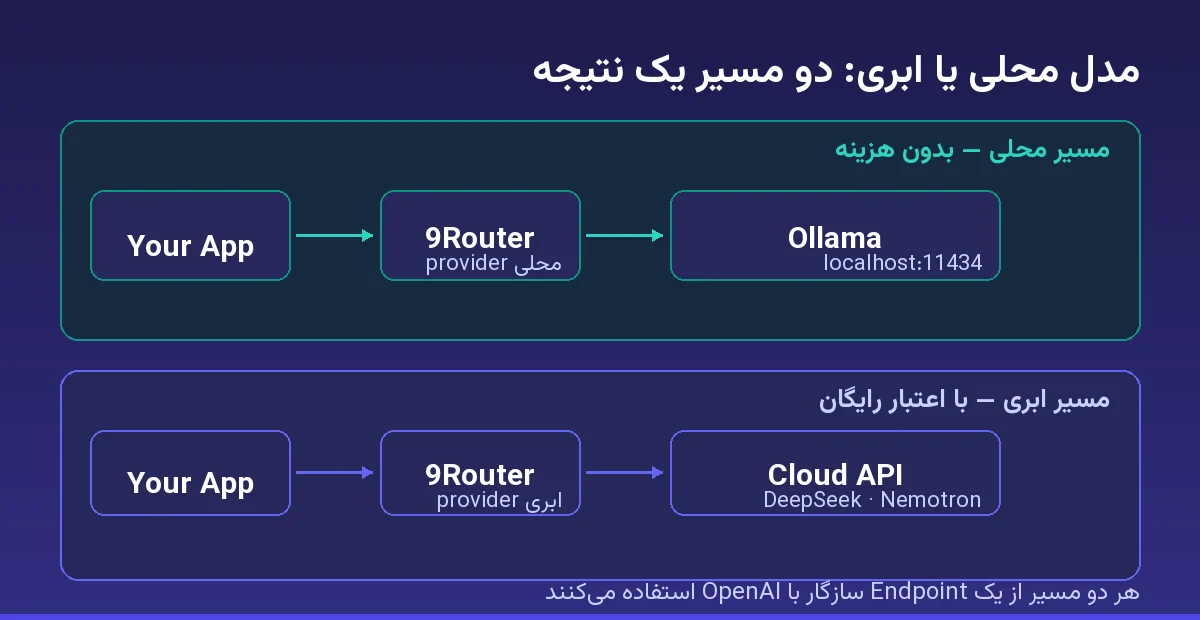
اتصال Ollama به 9Router بهعنوان provider محلی
روترها ارائهدهندهٔ سازگار با OpenAI را میپذیرند و Ollama هم چنین مسیری دارد. آدرس سازگار با OpenAI در Ollama این است:
http://localhost:11434/v1در 9Router، بخش Providers را باز کنید و یک ارائهدهندهٔ سازگار با OpenAI بسازید:
- Base URL:
http://localhost:11434/v1 - API Key: هر رشتهٔ دلخواه (Ollama محلی کلید نمیخواهد، اما بعضی ابزارها فیلد را اجباری میکنند)
- Model: همان نامی که با
ollama listدیدید
آدرس پیشفرض سرویس http://localhost:11434 و مسیر سازگار با OpenAI روی /v1 است؛ نام مدل هم در فیلد Model پذیرفته میشود. اگر نسخهٔ شما این مسیر را نپذیرفت، اول ollama --version را ببینید و بهروزرسانی کنید.
برای اینکه بدانید سرویس واقعاً بالا هست یا نه، پیش از هر تنظیمی این را اجرا کنید:
curl http://localhost:11434/api/tagsخروجی مورد انتظار: یک JSON با فهرست مدلهای نصبشده. اگر خطای اتصال گرفتید، مشکل در تنظیمات روتر نیست و سرویس بالا نیامده است.
ترتیب تست را رعایت کنید، وگرنه وقت زیادی صرف حدس میکنید: اول سرویس را با همان curl بالا ببینید، بعد یک درخواست گفتوگو مستقیم به Ollama بزنید، و در آخر روتر را امتحان کنید. اگر مرحلهٔ اول جواب داد و مرحلهٔ سوم نه، مقصر تنظیمات روتر است. اگر مرحلهٔ اول جواب نداد، هیچ تنظیمی در روتر نمیتواند درستش کند.
استفاده از مدل محلی در ابزارهای کدنویسی
هر ابزاری که ارائهدهندهٔ سازگار با OpenAI میپذیرد، به مدل محلی هم وصل میشود. اگر روتر را واسط گذاشتهاید، ابزارها را به روتر وصل کنید و مدل محلی را یکی از گزینههای زنجیره بگذارید.
ترتیب پیشنهادی برای کار روزمره:
- مدل محلی برای کارهای تکراری و کمریسک (نامگذاری، خلاصه، توضیح کوتاه).
- مدل ابری برای تغییر کد و بازبینی.
- مدل محلی به عنوان آخرین گزینه در زنجیرهٔ جانشین، وقتی شبکه قطع است.
یک نکتهٔ مهم: ابزارهای کدنویسی متن زیادی میفرستند. مدل محلی روی سیستم ۸ گیگی با پرامپتهای بلند کند میشود، حتی وقتی پاسخش کوتاه است. اگر ابزار کند شد، اول طول ورودی را کم کنید، بعد مدل را عوض کنید.
اگر تا حالا روتری نصب نکردهاید، راهنمای نصب 9Router در ویندوز همین لایه را از صفر توضیح میدهد.
در ابزارهای کدنویسی، دو تنظیم را جدی بگیرید: طول ورودی و سقف خروجی. مدل محلی روی سختافزار متوسط با ورودی طولانی کند میشود و اگر سقف خروجی را هم باز بگذارید، زمان انتظار غیرقابلتحمل میشود. برای کارهای ابزاری، سقف خروجی کوتاه بگذارید و به مدل بگویید پاسخ کوتاه بدهد.
مقایسهٔ مدل محلی با API رایگان: هزینه، سرعت، کیفیت
مقایسهٔ این دو با «کدام بهتر است» شروع نمیشود؛ با «چه چیزی را نمیتوانی بپردازی» شروع میشود.
| معیار | مدل محلی (Ollama) | API ابری |
|---|---|---|
| هزینهٔ هر درخواست | صفر، بعد از دانلود | بر پایهٔ توکن؛ با اعتبار رایگان شروع میشود |
| سرعت | وابسته به سختافزار شما | وابسته به شبکه و صف سرویس |
| حریم خصوصی | داده از سیستم خارج نمیشود | داده به سرویس بیرونی میرود |
| کیفیت | مدل کوچک، محدود در استدلال و کد | مدل بزرگتر، قویتر در کارهای پیچیده |
| محدودیت سهمیه | ندارد | سقف روزانه و محدودیت نرخ |
ترکیب عملی که بیشتر وقتها جواب میدهد: مدل محلی برای حجم و دادهٔ حساس، API برای کیفیت. اگر اعتبار رایگان میخواهید تا هزینهٔ صفر را با کیفیت بالاتر تجربه کنید، راهنمای اعتبار رایگان و فهرست مدلها نقطهٔ شروع است.
محدودیتهای واقعی: رم، کارت گرافیک، طول پاسخ
سه محدودیت که در هفتهٔ اول به آنها میخورید:
یک: رم. اگر مدل بزرگتر از حافظهٔ موجود باشد، سیستم شروع به تعویض حافظه میکند و سرعت به شدت افت میکند. نشانهاش واضح است: پاسخها یکییکی میآیند و هارد درگیر میشود. راهحل، مدل کوچکتر است، نه صبر بیشتر.
دو: کارت گرافیک. لایهای از مدل که در حافظهٔ کارت جا شود سریع اجرا میشود و بقیه روی پردازنده میماند. با ۲ گیگابایت حافظهٔ گرافیک، بخش کمی از مدل ۷B در کارت جا میشود و بقیه روی پردازنده اجرا میشود.
سه: طول پاسخ. مدل محلی، حافظهٔ کاری محدودی دارد. اگر گفتوگو طولانی شود، کیفیت افت میکند یا پاسخ قطع میشود. برای کارهای طولانی، خلاصهٔ مرحلهای بسازید و گفتوگو را تازه کنید.
این محدودیت چهارم که کمتر گفته میشود: مدل محلی از دانش روز بیخبر است. اگر مدل روی دادههای قدیمی آموزش دیده باشد، دربارهٔ نسخههای تازه چیز درستی نمیداند و با اعتماد کامل اشتباه میگوید.
رفع خطاهای رایج اتصال به Ollama
خطای اتصال برقرار نشد. سرویس بالا نیست. یک بار ollama serve را در یک پنجرهٔ جدا اجرا کنید و ببینید پیام خطا چیست. اگر پورت اشغال بود، پیام صریح میدهد.
مدل پیدا نشد. نام مدل در ابزار با نام نصبشده یکی نیست. نام دقیق را از ollama list بردارید و همان را بنویسید؛ تگها حساس به حروف و نسخهاند.
پاسخ میآید ولی کوتاه یا بیربط است. معمولاً طول ورودی بیشتر از ظرفیت مدل است یا پارامترهای خروجی محدود شدهاند. اول ورودی را کوتاه کنید.
ابزار وصل میشود ولی روتر نه. اگر ابزار مستقیم به localhost وصل است و روتر روی ماشین دیگری اجرا میشود، بهجای نام محلی، آدرس ماشین میزبان را بدهید و مطمئن شوید سرویس فقط روی همان ماشین گوش نمیدهد.
کندی بعد از چند دقیقه. مدلهای بارگذاریشده در حافظه میمانند. با ollama ps ببینید چه چیزی در حال اجراست و مدلهای بیاستفاده را ببندید.
ابزار به سرویس نمیرسد ولی مرورگر جواب میدهد. اگر ابزار در محیطی اجرا میشود که شبکهاش جدا از سیستم شماست (مثلاً داخل یک محیط ایزوله)، localhost آن محیط به سیستم شما اشاره نمیکند. در این حالت باید سرویس روی شبکه در دسترس باشد و آدرس ماشین میزبان داده شود، نه نام محلی.
خطای احراز هویت در ابزاری که به روتر وصل است. بعضی ابزارها فیلد کلید را اجباری میکنند، حتی وقتی ارائهدهنده کلید نمیخواهد. یک رشتهٔ دلخواه بگذارید و ادامه دهید؛ این خطا از Ollama نمیآید.
این مقاله بخشی از دستهٔ هوش مصنوعی است. اگر تازه شروع کردهاید، از نقشهٔ راه هوش مصنوعی شروع کنید تا ترتیب مطالعه را بدانید.
سؤالات متداول دربارهٔ اجرای مدل محلی روی ویندوز
آیا Ollama به کارت گرافیک نیاز دارد؟
نه، ولی سرعت را زیاد میکند. بدون کارت، مدل روی پردازنده اجرا میشود و کار میکند؛ فقط کندتر.
آدرس پیشفرض سرویس چیست و مسیر سازگار با OpenAI کدام است؟
سرویس روی http://localhost:11434 گوش میدهد و مسیر سازگار با OpenAI در /v1 است. این دو مقدار از مستندات رسمی Ollama است.
با ۸ گیگابایت رم چه مدلی اجرا کنم؟
مدلهای ۳B تا ۴B. مدل ۷B هم بالا میآید ولی روی این رده کند است و تجربهٔ روزمره نمیدهد.
مدل محلی جای API را میگیرد؟
برای کارهای ساده و پرتعداد بله؛ برای استدلال پیچیده و پروژهٔ کد بزرگ نه. ترکیب هر دو، واقعبینانهترین انتخاب است.
چطور به 9Router وصلش کنم؟
در بخش Providers یک ارائهدهندهٔ سازگار با OpenAI بسازید، Base URL را http://localhost:11434/v1 بگذارید و نام مدل را از ollama list بردارید.
دادههای من جایی فرستاده میشود؟
در اجرای محلی، مدل روی سیستم خودتان اجرا میشود و متن از دستگاه خارج نمیشود. این تفاوت اصلی با API ابری است.