خطای ۵۰۲ Bad Gateway در وردپرس (WordPress 502 Error) یعنی سروری که نقش واسطه را دارد — CDN، پروکسی، یا وبسرور — پاسخی از سرویس بالادست گرفت که نتوانست بپذیرد. در یک سایت وردپرسی، این واسطه تقریباً همیشه nginx است و بالادست هم PHP-FPM که کد وردپرس را اجرا میکند. پس پیام مرورگر فقط یک چیز میگوید: PHP پاسخ معتبر نداد. اینکه چرا، در لاگ همان واسطه نوشته شده و با یک عدد داخل پرانتز مشخص میشود. کار درست، حدس زدن دربارهٔ افزونهٔ مقصر نیست؛ پیدا کردن لایهای است که پاسخ را ساخته. این راهنما از همان لایه شروع میکند و پایین میرود: CDN، وبسرور، PHP-FPM، و بالادست. اگر خطای ۵۰۰ گرفتهاید، آن یکی داستان جدا دارد و در هاب خطاهای وردپرس کنار بقیهٔ کدها نشسته است.
خطای ۵۰۲ یعنی کدام لایه جواب نداده
تعریف رسمی ۵۰۲ در RFC 9110 این است: سرور در نقش دروازه یا واسط، از سروری که برای تکمیل درخواست به آن مراجعه کرده، پاسخ نامعتبر دریافت کرده است. سه کلمه در این تعریف مهم است. «دروازه» یعنی پاسخدهنده، خودِ برنامه نیست. «بالادست» یعنی جایی که واسط به آن وصل شده. «نامعتبر» یعنی پاسخ یا نرسیده، یا نصفه رسیده، یا آنقدر دیر رسیده که واسط صبر نکرده.
در معماری رایج وردپرس، واسط همان nginx است و بالادست همان PHP-FPM. ولی این تنها ترکیب ممکن نیست. اگر کلودفلر جلوی سایت باشد، واسط اول کلودفلر است و مبدأ سایت بالادست آن. اگر از Cloudflare Tunnel استفاده میکنید، یک واسط دیگر هم وسط است. اگر پشت لودبالانسر هاست اشتراکی هستید، آن هم واسط است. هر لایهای که هم درخواست را میگیرد و هم به جایی دیگر وصل میشود، میتواند ۵۰۲ بسازد و همان لایه هم لاگ خودش را دارد.
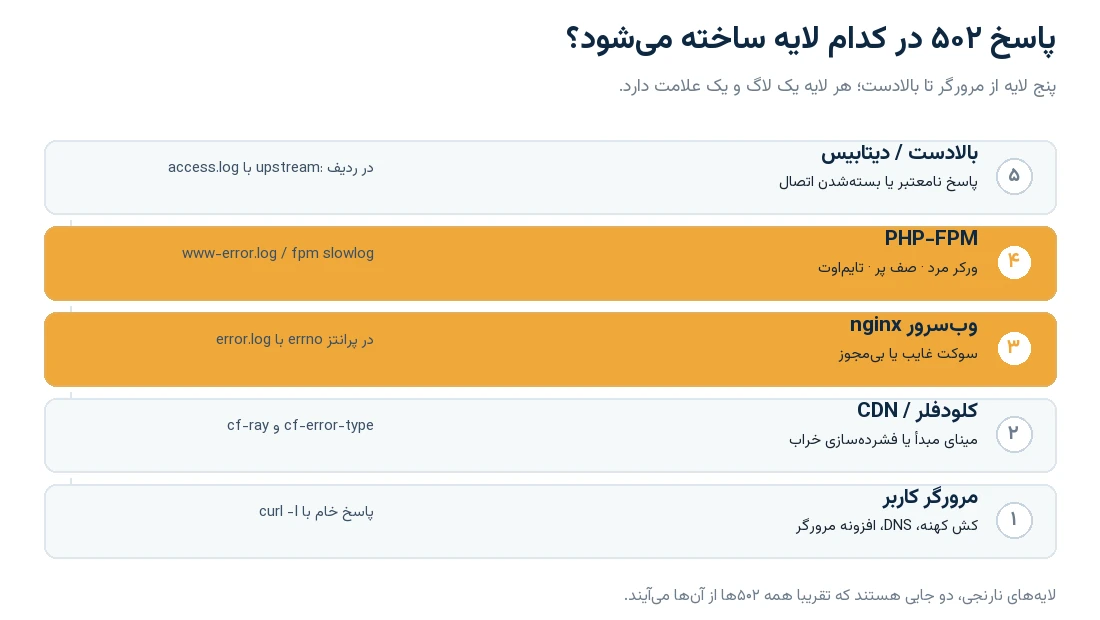
اینکه کدام لایه پاسخ را ساخته، از دو چیز فهمیده میشود: شکل صفحهٔ خطا و نام سرور در هدر پاسخ. صفحهای که لوگوی کلودفلر دارد با صفحهای که فقط نوشته «502 Bad Gateway» و زیرش «nginx» است، دو دنیای متفاوتاند. اولی را لبه ساخته، دومی را وبسرور خودتان. اگر همین یک تفکیک را درست انجام دهید، نیمی از مسیر رفته است؛ چون توصیهٔ «افزونهها را خاموش کن» فقط برای حالت دوم معنا دارد و در حالت اول اتلاف وقت است.
| لایه | نشانهای که میبینید | لاگی که باید بخوانید | چه چیزی را ثابت میکند |
|---|---|---|---|
| CDN / کلودفلر | صفحهٔ برنددار با Ray ID یا صفحهٔ سفید بیبرند | پاسخ خام با curl -I | خطا پیش از رسیدن به سایت رخ داده |
| وبسرور nginx | صفحهٔ ساده با نام nginx | error.log با errno در پرانتز | nginx نتوانسته به PHP وصل شود |
| PHP-FPM | همان صفحهٔ nginx، ولی فقط در صفحههای PHP | php-fpm.log و slowlog | ورکر مرده، صف پر است، یا تایماوت خورده |
| بالادست / دیتابیس | ۵۰۲ پراکنده با ۵۰۴ کنارش | access.log و لاگ دیتابیس | اتصال به سرویس بعدی شکسته است |
تشخیص لایهٔ خطا در سه دقیقه
قبل از هر تغییری، سه چیز را ثبت کنید: زمان دقیق با منطقهٔ زمانی، آدرس دقیقی که خطا داد، و اینکه خطا در همهٔ صفحهها هست یا فقط بعضی. این سه قلم بعداً در تطبیق لاگ و در تیکت به میزبان هر دو به کار میآید و اگر ثبت نشود، حدس جای تشخیص مینشیند.
بعد محدوده را بسنجید. یک صفحهٔ ایستا و یک صفحهٔ PHP را با هم بزنید. اگر هر دو ۵۰۲ دادند، مسئله پیش از PHP است. اگر فقط PHP ۵۰۲ داد، مسئله داخل PHP-FPM است. اگر فقط یک آدرس خاص ۵۰۲ داد، مسئله در همان اسکریپت یا همان افزونهای است که در آن مسیر اجرا میشود. این سه حالت، سه مسیر کاملاً متفاوت برای ادامهٔ کار میسازند و در کمتر از یک دقیقه از هم جدا میشوند.
سوم، پاسخ خام را بگیرید؛ نه آنچه مرورگر نشان میدهد. مرورگر صفحهٔ خطا را رندر میکند و هدرها را پنهان نگه میدارد. هدرها اسم سرور، وجود CDN، و شمارهٔ Ray را حمل میکنند و همینها لایه را لو میدهند:
curl -sS -D - -o /dev/null --max-time 15 https://example.com/wp-login.php

HTTP/2 502
server: nginx
date: Mon, 16 Nov 2026 08:41:02 GMT
content-type: text/html
content-length: 157
در پاسخ بالا، server: nginx و نبودِ cf-ray میگوید درخواست از هیچ CDNی عبور نکرده و خطا از وبسرور خودتان آمده. اگر جای server: nginx نوشته بود server: cloudflare و یک هدر cf-ray هم داشت، ترتیب بررسی برعکس میشد و اول باید میفهمیدیم لبه خطا داده یا مبدأ. نکتهٔ ریز ولی مهم: curl -I درخواست HEAD میفرستد و بعضی CDNها HEAD را از کش جواب میدهند در حالی که GET خطا دارد. برای تشخیص، همان GET با -D - معتبرتر است.
زمان پاسخ هم یک سرنخ است. اگر ۵۰۲ در چند میلیثانیه برگردد، هیچ اتصالی برقرار نشده؛ سوکت غایب است یا اتصال رد شده. اگر سه تا سی ثانیه طول بکشد، کسی منتظر مانده و بعد بریده؛ آنجا سقف زمان اجرا یا کندی دیتابیس دخیل است. اگر خطا همیشه چند ثانیه بعد از یک عملیات خاص بیاید — ذخیرهٔ یک نوشته، اجرای یک گزارش، آپلود یک فایل — آدرس همان عملیات را دارید.
تست فایل ایستا برای جدا کردن PHP از وبسرور
تست فایل ایستا لایهٔ خطا را جدا میکند، و ارزانترین تستی است که میتوانید انجام دهید. یک فایل ایستا را بخواهید، بعد یک صفحهٔ PHP را. فایل ایستا را nginx خودش از دیسک میخواند و اگر سالم برگشت، یعنی وبسرور زنده است، سوکت و پورت و DNS و CDN هم سالماند. پس خطا در لایهٔ PHP است.
# ایستا: nginx خودش جواب میدهد
curl -sS -o /dev/null -w 'static %{http_code} %{time_total}sn' https://example.com/robots.txt
# PHP: درخواست به PHP-FPM پاس میشود
curl -sS -o /dev/null -w 'php %{http_code} %{time_total}sn' https://example.com/wp-login.php
# پویا بدون وردپرس: اگر این سالم بود، وردپرس مقصر است نه FPM
curl -sS -o /dev/null -w 'static2 %{http_code} %{time_total}sn' https://example.com/wp-includes/css/dist/block-library/style.min.css
سه خروجی ممکن است و هر سه معنا دارد. اگر ایستا ۲۰۰ و PHP ۵۰۲ بود، سراغ PHP-FPM بروید و بخشهای بعدی را به ترتیب بخوانید. اگر هر دو ۵۰۲ بودند، مسئله بالاتر از PHP است؛ یا nginx کلاً بالا نیامده، یا CDN به مبدأ نمیرسد. اگر ایستا هم ۲۰۰ نبود ولی کد خطا ۴۰۴ یا ۴۰۳ بود، شما اصلاً ۵۰۲ ندارید و باید دنبال خطای دیگری بروید.
یک نکتهٔ ظریف که وقت زیادی را نجات میدهد: فایل ایستایی انتخاب کنید که واقعاً از دیسک خوانده شود، نه از کش CDN. آدرس یک CSS یا robots.txt را با یک پارامتر تصادفی صدا بزنید تا از کش لبه رد شود؛ وگرنه ممکن است نسخهٔ کششدهٔ سالم را ببینید و به این نتیجهٔ غلط برسید که وبسرور سالم است. برای همین، در فرمان بالا زمان پاسخ هم چاپ میشود: پاسخ کششده با پاسخ تازه، در زمان و در هدر cf-cache-status فرق میکنند.
خطای ۵۰۲ از سمت CDN و کلودفلر
وقتی کلودفلر جلوی سایت است، دو نوع ۵۰۲ وجود دارد و درمانشان یکی نیست. نوع اول: مبدأ خودش ۵۰۲ برگردانده و کلودفلر همان را با ظاهر خودش به بازدیدکننده نشان داده. نوع دوم: کلودفلر خودش خطا را ساخته، چون پاسخی که از مبدأ گرفت قابل پردازش نبود. مستندات کلودفلر هر دو حالت را فهرست میکند و راه تشخیص را هم میدهد: در حالت اول مشکل در مبدأ است، در حالت دوم مشکل در لبه.
برای حالت دوم، مستندات رسمی دو علت مشخص نام میبرد. یکی فشردهسازی خراب: مبدأ محتوای gzip میفرستد ولی هدر Content-Length را بهروز نمیکند، یا بدنهٔ gzip شکسته میفرستد. دیگری ازدحام موقت یک دیتاسنتر که خودش در چند ثانیه رد میشود. اگر با خاموش کردن فشردهسازی در مبدأ خطا رفت، علت اول را پیدا کردهاید.
حالت اول — خطای مبدأ که کلودفلر فوروارد کرده — در ۹ مورد از ۱۰ مورد همان ۵۰۲یی است که در بخشهای بعدی میخوانید؛ یعنی باید لاگ خود سرور را ببینید. کلودفلر در این حالت کاری جز عبور پاسخ نداشته و تیکت دادن به کلودفلر چیزی را حل نمیکند. مستنداتش هم همین را میگوید: برای این دسته با میزبان تماس بگیرید.
راه درست تست مبدأ بدون خاموش کردن CDN، این است که درخواست را با هدر Host درست به IP مبدأ بفرستید. خاموش کردن CDN یک تغییر در محیط تولید است و اگر خطا از مبدأ باشد، فقط DNS و کش را هم به هم میریزد. تست مبدأ بدون خاموش کردن CDN با curl --resolve انجام میشود و هیچ چیزی را در پنل تغییر نمیدهد:
# نام دامنه را به IP مبدأ قفل کن؛ DNS و CDN دور زده میشوند
curl -sS -D - -o /dev/null --max-time 15
--resolve example.com:443:203.0.113.10
https://example.com/wp-login.php
دو خروجی این تست را درست بخوانید. اگر همان ۵۰۲ برگشت، خطا در مبدأ است و کلودفلر بیگناه؛ بروید سراغ لاگ nginx. اگر ۲۰۰ برگشت ولی از مسیر عادی ۵۰۲ میگیرید، مسئله بین لبه و مبدأ است — تنظیمات SSL، پورت، یا فایروال مبدأ که IPهای کلودفلر را میبندد. و اگر خطای گواهی گرفتید، این هم بیمعنا نیست: نشان میدهد مبدأ برای این نام، گواهی معتبری که curl قبولش کند ندارد و کلودفلر در حالت Full (strict) همین را ۵۰۲ میبیند.
تفکیک خطای لبه با هدرهای cf-ray
هدرها به شما میگویند پاسخ از کجا آمده. cf-ray روی هر پاسخی که از شبکهٔ کلودفلر عبور کند وجود دارد و برای پیگیری در پشتیبانی همان شناسهای است که میخواهند. ولی cf-error-type و cf-error-origin فقط روی صفحههای خطایی میآیند که خود کلودفلر ساخته است؛ نبودنشان ثابت نمیکند کلودفلر دخیل نبوده، فقط میگوید این صفحه را مبدأ فرستاده.
curl -sS -D - -o /dev/null --max-time 15 https://example.com/ | grep -iE '^(server|cf-ray|cf-cache-status|cf-error)'

server: cloudflare
cf-ray: 8f31c2a4be0d2f11-CDG
cf-cache-status: DYNAMIC
در نمونهٔ بالا، خطای لبه رخ نداده و پاسخ از مبدأ آمده؛ DYNAMIC هم میگوید از کش سرو نشده. اگر جای اینها cf-error-type: 502 میدیدید، یعنی صفحه را خود کلودفلر ساخته و باید فشردهسازی و وضعیت دیتاسنتر را بررسی کنید. اگر server: cloudflare بود ولی هیچکدام از این دو نبود، پاسخ از مبدأ فوروارد شده و لاگ سرور حرف آخر را میزند.
یک تفکیک دیگر هم شکل صفحه میدهد: در حالت «۵۰۲ از CDN» صفحه سفید و بیبرند است، در حالت «۵۰۲ از مبدأ» صفحهٔ کلودفلر با لوگو و Ray ID دیده میشود. این قاعده کلی است ولی استثنا دارد؛ قالب خطای سفارشی میتواند ظاهر را عوض کند. برای همین هدر را باور کنید، نه ظاهر را.
و یک چیز که نباید با ۵۰۲ اشتباه بگیرید: کدهای ۵۲x خود کلودفلر. ۵۲۱ یعنی وبسرور داون است، ۵۲۲ یعنی اتصال تایماوت شد، ۵۲۳ یعنی مبدأ دسترسناپذیر است، ۵۲۴ یعنی بعد از اتصال، پاسخ در زمان مقرر نیامد. اگر یکی از اینها را میبینید، عدد خودش لایه را نشان داده و لازم نیست تست ۵۰۲ را تکرار کنید. تفاوت مهم: اگر کلودفلر اصلاً نتواند به مبدأ وصل شود، ۵۲۱ یا ۵۲۲ میدهد نه ۵۰۲.
خطای ۵۰۲ از وبسرور nginx
nginx وقتی ۵۰۲ میدهد که اتصال به بالادست برقرار نشده، یا پاسخ بالادست را نتوانسته بپذیرد. در این حالت nginx سالم است؛ خودش دارد کارش را میکند و خبر میدهد که پاییندستی مشکل دارد. این را از دو جا میفهمید: nginx -t میگوید پیکربندی درست است، و systemctl status nginx میگوید سرویس بالاست. اگر یکی از این دو خطا داد، بحث دیگری دارید و اول باید همان را حل کنید.
لاگ دسترسی، ۵۰۲ را نشان میدهد ولی علت را نه. علت در لاگ خطا است و هر خطا یک ردیف دارد. مسیر پیشفرض /var/log/nginx/error.log است، ولی همیشه نه: هر server block میتواند error_log خودش را داشته باشد و در آن صورت فایل پیشفرض خالی میماند. اول بپرسید لاگ کجاست، بعد بخوانید:
# کدام فایل لاگ واقعاً بارگذاری شده؟
nginx -T 2>/dev/null | grep -nE '^s*error_log|fastcgi_pass|proxy_pass'
# ردیفهای مربوط به بالادست، تازهترین آخر
sudo grep -E 'upstream|connect()|recv()' /var/log/nginx/error.log | tail -n 20
خروجی nginx -T کل پیکربندی بارگذاریشده را چاپ میکند و میتواند رمز و کلید داشته باشد؛ آن را در تیکت یا انجمن نچسبانید. کاری که با آن میکنید فقط این است: ببینید fastcgi_pass به کجا اشاره میکند و همان مسیر را با آنچه واقعاً روی سرور وجود دارد مقایسه کنید. بیشتر ۵۰۲های بعد از ارتقای PHP همینجا حل میشوند، چون سوکت از php8.2-fpm.sock به php8.3-fpm.sock عوض شده و پیکربندی جا مانده است.
اگر خطا فقط در یک مسیر خاص است، لاگ همان ردیف را با آدرس درخواست نشان میدهد و کار را کوتاه میکند. اگر همهٔ مسیرها ۵۰۲ میدهند، مسئله سرویس است نه کد. و اگر .htaccess را اخیراً دستکاری کردهاید، به یاد داشته باشید زیر nginx این فایل خوانده نمیشود و مشکل از آن نیست؛ اما اگر روی Apache یا LiteSpeed هستید، یک دستور نادرست در .htaccess میتواند کل سایت را از کار بیندازد. ساختار این فایل و کاری که هر بلوکش میکند در راهنمای فایل .htaccess در وردپرس آمده است.
نگاشت errno در لاگ خطای nginx
شمارهٔ errno در لاگ nginx لایهٔ خراب را نام میبرد، و این تنها جایی است که nginx به شما میگوید دقیقاً چه چیزی شکست. عدد داخل پرانتز، errno سیستمعامل است و هر مقدار یک درمان متفاوت دارد. کسی که فقط میخواند «۵۰۲» و میرود افزونه خاموش کند، همین عدد را ندیده است.
یک ردیف کامل چنین شکلی دارد. سه فیلد مهم دارد: عدد داخل پرانتز، آدرس upstream: که همان جایی است که nginx تلاش کرده، و request: که میگوید یک مسیر خاص بوده یا همه.
2026/11/16 08:41:02 [error] 2187#2187: *4410 connect() to unix:/run/php/php8.3-fpm.sock failed (2: No such file or directory) while connecting to upstream, client: 203.0.113.7, server: example.com, request: "GET /wp-login.php HTTP/1.1", upstream: "fastcgi://unix:/run/php/php8.3-fpm.sock:", host: "example.com"
| errno | پیام در لاگ | معنا | اولین بررسی |
|---|---|---|---|
| 2 | No such file or directory | سوکت یا مسیر وجود ندارد: FPM خاموش است یا مسیر عوض شده | ls -l /run/php/ |
| 13 | Permission denied | کاربر nginx اجازهٔ باز کردن سوکت را ندارد | listen.owner و listen.mode |
| 111 | Connection refused | چیزی آنجا گوش نمیدهد: سوکت مرده یا پورت اشتباه | ss -xlp و ss -tlnp |
| 11 | Resource temporarily unavailable | صف سوکت پر است: همهٔ ورکرها مشغولاند | pm.max_children |
| 104 | Connection reset by peer | بالادست وسط درخواست مرد: OOM یا تایماوت | لاگ FPM و request_terminate_timeout |
| 110 | Connection timed out | پاسخ در زمان مقرر نیامد | معمولاً ۵۰۴ میگیرید، نه ۵۰۲ |
تفاوت ۲ و ۱۱۱ ظاهراً کوچک است ولی مسیر کار را عوض میکند. در ۲، فایل سوکت نیست؛ یعنی سرویس بالا نیامده یا نامش در پیکربندی قدیمی مانده. در ۱۱۱، فایل سوکت هست ولی کسی پشتش جواب نمیدهد؛ یعنی ورکرها مردهاند یا audible نیستند. اولی را با systemctl start php8.3-fpm حل میکنید، دومی را با پیدا کردن دلیل مرگ ورکرها.
errno 11 تنها عددی است که مستقیم به ظرفیت اشاره میکند و با هیچ تنظیمی در وردپرس حل نمیشود. اگر این عدد را میبینید، سایت شما به سقف تعداد پردازههای PHP رسیده و هر درخواست تازهای که برسد در صف میماند. نشانهٔ عملیاش این است که سایت بیشتر وقتها سالم است و در بازههای کوتاه، همهچیز با هم ۵۰۲ میشود.
خطای ۵۰۲ از PHP-FPM و صف ورکر
PHP-FPM تعداد ثابتی ورکر دارد و هر ورکر در هر لحظه یک درخواست را اجرا میکند. مجموعهٔ این ورکرها یک استخر است با سقفی به نام pm.max_children. وقتی همهٔ ورکرها مشغول باشند، درخواست تازه در صف مینشیند. اگر صف هم پر شود، هستهٔ سیستم اتصال را رد میکند و nginx همان errno 11 را ثبت میکند.
سقف را باید از حافظه حساب کرد، نه از حدس. اگر هر پردازهٔ PHP در اوج مصرف حدود ۸۰ مگابایت بردارد و بودجهٔ PHP روی سرور یک گیگابایت باشد، سقف منطقی حدود دوازده ورکر است؛ بیشتر از آن، حافظه تمام میشود و هسته پردازهها را میکشد — که خودش ۵۰۲ میسازد. عدد دقیق در هر سایت فرق دارد و باید از مصرف واقعی همان سایت گرفته شود، ولی منطقش همیشه همین است.
; /etc/php/8.3/fpm/pool.d/www.conf
pm = dynamic
pm.max_children = 12
pm.start_servers = 3
pm.min_spare_servers = 2
pm.max_spare_servers = 6
pm.max_requests = 500
; ورکری که از این بیشتر طول بکشد کشته میشود و nginx ۵۰۲ میبیند
request_terminate_timeout = 120s
request_slowlog_timeout = 5s
slowlog = /var/log/php8.3-fpm-slow.log
listen = /run/php/php8.3-fpm.sock
listen.owner = www-data
listen.group = www-data
listen.mode = 0660
listen.backlog = 511
عدد request_terminate_timeout کلید ماجراست. مقدار صفر یعنی خاموش، که پیشفرض است؛ یعنی PHP-FPM هیچ سقفی برای خودش ندارد و منتظر میماند تا حد بالادست صبر تمام شود. در آن حالت nginx زودتر خسته میشود و ۵۰۴ میدهد. اگر برعکس، این عدد را کمتر از تایماوت nginx بگذارید، FPM ورکر را میکشد و nginx همان لحظه ۵۰۲ میبیند. کدام کد میگیرید، به همین ترتیب بستگی دارد نه به نوع خطا.
اندازهٔ استخر در هاست اشتراکی دست شما نیست و میزبان آن را برای همه تعیین میکند. این تفاوت اصلی هاست مدیریتشده و هاست اشتراکی است: در اولی استخر هر سایت جداست، در دومی یک استخر بین چند سایت تقسیم میشود و سایت پرمصرف همسایه، ۵۰۲ شما را میسازد. اگر ۵۰۲ شما همیشه در ساعتهای پیک و همزمان با کندی کل سرور میآید، همین را در تیکت بنویسید.
تنظیم upstream و تایماوت در nginx
کدام تایماوت اول شلیک میکند، کد پاسخ را تعیین میکند. این جمله را در ذهن نگه دارید، چون بیشتر توصیههای اینترنتی («زمان اجرا را زیاد کن») بدون فهم همین ترتیب، خطا را جابهجا میکند نه حل. سه عدد در بازی است: fastcgi_read_timeout در nginx، request_terminate_timeout در PHP-FPM، و max_execution_time در خود PHP.
ترتیب طبیعی این است: nginx صبر میکند، PHP-FPM صبر میکند، PHP هم سقف خودش را دارد. اگر nginx اول خسته شود، پاسخ ۵۰۴ است. اگر PHP-FPM اول ورکر را بکشد، nginx اتصال را قطعشده میبیند و ۵۰۲ میدهد. اگر max_execution_time اول برسد، PHP خودش خطای مهلک میدهد و آن هم به ۵۰۰ یا ۵۰۲ تبدیل میشود، بسته به اینکه خروجی چقدر تولید شده باشد.
upstream php_fpm {
    server unix:/run/php/php8.3-fpm.sock;
    keepalive 16;
}

server {
    location ~ .php$ {
        include fastcgi_params;
        fastcgi_pass php_fpm;
        fastcgi_connect_timeout 10s;
        fastcgi_send_timeout    60s;
        fastcgi_read_timeout    90s;
        fastcgi_buffers 16 16k;
        fastcgi_buffer_size 32k;

        # ۵۰۲ را به کاربر بعدی نسپار
        fastcgi_next_upstream error timeout invalid_header;
    }
}
دو تنظیم در این بلوک کمتر دیده میشود و هر دو به ۵۰۲ مربوطاند. fastcgi_buffer_size و fastcgi_buffers وقتی مهم میشوند که پاسخ هدر بزرگی داشته باشد؛ اگر بافر کوچک باشد، nginx پیام «upstream sent too big header» ثبت میکند و ۵۰۲ میدهد — خطایی که با هیچ تغییری در وردپرس حل نمیشود. fastcgi_next_upstream هم تعیین میکند در چه خطاهایی درخواست به سرور بعدی برود؛ با یک سرور بالادست بیاثر است، ولی در استخر چندسروره جلوی ۵۰۲ غیرضروری را میگیرد.
یک هشدار عملی: بزرگ کردن بیحساب fastcgi_read_timeout خطا را پنهان میکند نه حل. اگر ۹۰ ثانیه را ۶۰۰ کنید، کاربر هنوز ۵۰۲ یا ۵۰۴ میگیرد، فقط دیرتر — و در این فاصله ورکر اشغال مانده و صف پرتر شده است. نشانهٔ این اشتباه دقیقاً همان الگویی است که در errno 11 دیدیم: سایت چند دقیقه سالم، بعد همهچیز با هم خراب.
خواندن لاگ PHP-FPM و slowlog
لاگ PHP-FPM جایی است که مرگ ورکرها ثبت میشود. مسیرش به توزیع بستگی دارد: در Debian و Ubuntu معمولاً /var/log/php8.3-fpm.log است، در پیکربندیهای دیگر مسیر در خود pool با کلید error_log تعیین میشود و مقدار syslog هم پذیرفته است. اگر سایت شما با systemd مدیریت میشود، خروجی سرویس هم همانجا جمع میشود:
# اگر سرویس زیر systemd است
journalctl -u php8.3-fpm --since "15 min ago" -p warning --no-pager -o short-iso

# اگر لاگ فایل است
sudo tail -n 80 /var/log/php8.3-fpm.log
در خروجی دنبال سه الگو بگردید. «pool www seems busy» یعنی استخر به سقفش رسیده و صف دارد شکل میگیرد. «child exited on signal 9» یعنی هستهٔ سیستم پردازه را بهخاطر حافظه کشته و این تقریباً همیشه ۵۰۲ میسازد. «execution timed out» یعنی سقف زمان اجرا رسیده و FPM خودش ورکر را کشته است.
اما مهمترین ابزار، slowlog است. لاگ خطا فقط میگوید ورکر مرد؛ نمیگوید کدام کد وقت میخورد. با روشن کردن request_slowlog_timeout، FPM هر درخواستی که از آن حد بگذرد را با پشتهٔ فراخوانی — نام فایل و شمارهٔ خط — ثبت میکند. این تنها آرتیفکتی است که انگشت روی کد مقصر میگذارد، نه روی سرویس.
[16-Nov-2026 08:44:19]  [pool www] pid 31842
script_filename = /var/www/example.com/public_html/wp-admin/admin-ajax.php
[0x00007f3c1a2b4e10] curl_exec() /var/www/example.com/public_html/wp-includes/class-wp-http-curl.php:466
[0x00007f3c1a2b50a0] request() /var/www/example.com/public_html/wp-includes/class-wp-http.php:419
[0x00007f3c1a2b52d0] wp_remote_get() /var/www/example.com/public_html/wp-content/plugins/example-plugin/sync.php:88
این نمونه دقیقاً همان چیزی است که در سایتهای وردپرسی زیاد دیده میشود: یک افزونه با wp_remote_get() به یک API بیرونی وصل میشود و آن API جواب نمیدهد. نه حافظه تمام شده، نه کد غلط است؛ یک ورکر فقط مدت طولانی منتظر مانده. اگر همهٔ ورکرها همزمان درگیر چنین انتظاری شوند، سایت ۵۰۲ میشود و هیچ لاگ خطایی هم دیده نمیشود، چون هیچ خطایی رخ نداده — فقط کندی.
دستورهای بررسی بدون تغییر تنظیمات
قاعدهٔ ساده: در بحران، اول بخوان، بعد تغییر بده. هر تغییری که بدون خواندن انجام شود، یک متغیر ناشناخته به مسئله اضافه میکند و بعد از آن نمیدانید خطا از تنظیم جدید است یا از مشکل قبلی. فهرست زیر فقط وضعیت را میخواند و روی سرور شما چیزی را عوض نمیکند.
# آیا سرویسها بالا هستند؟
systemctl status nginx --no-pager
systemctl status php8.3-fpm --no-pager
# پیکربندی nginx درست است؟ (بدون reload)
sudo nginx -t
# سوکتهای PHP-FPM و صف شنود
ls -l /run/php/
ss -xlp | grep php
ss -tlnp | grep -E ':(80|443)b'
# وضعیت خود استخر، اگر status page روشن باشد
curl -s http://localhost/status?full | head -n 20
# یک درخواست واقعی، با زمان و کد
curl -sS -o /dev/null -w '%{http_code} %{time_connect}s %{time_total}sn'
https://example.com/wp-login.php
خروجی nginx -t اگر «syntax is ok» و «test is successful» داد، یعنی ۵۰۲ از پیکربندی nginx نیست. اگر خطا داد و nginx هنوز دارد سرویس میدهد، یعنی نسخهٔ بارگذاریشده با فایل روی دیسک یکی نیست؛ تا آن خطا حل نشود، reload نکنید. خروجی ss -xlp هم فهرست سوکتهای یونیکس را با پردازهٔ مالک نشان میدهد و سه سؤال را یکجا جواب میدهد: سوکت هست یا نه، چه کسی مالکش است، و نام دقیقش چیست.
اگر به پوستهٔ سرور دسترسی ندارید، از WP-CLI روی هاست اشتراکی استفاده کنید. wp plugin list و wp cron event list و wp option get home بدون نیاز به پیشخوان جواب میدهند و در حالت ۵۰۲ که پیشخوان باز نمیشود، تنها راه دیدن وضعیت سایتاند. روش نصب و دستورهای پرکاربردش در راهنمای WP-CLI روی هاست اشتراکی آمده است. یک هشدار: WP-CLI هم از همان PHP-FPM استفاده میکند؛ اگر استخر پر باشد، این دستورها هم کند میشوند یا میمانند.
و یک نکتهٔ آماری که در تشخیص کمک میکند: در لاگ دسترسی، نسبت ۵۰۲ به کل درخواستها را حساب کنید. اگر در یک بازهٔ دهدقیقهای ۲۰ درخواست از ۲۰۰ درخواست ۵۰۲ بوده، مسئله مقطعی است. اگر ۲۰۰ از ۲۰۰ بوده، سرویس مرده است. این نسبت را با شمارش ساده بگیرید، نه با حس:
sudo awk '$9 == 502 {n++} {t++} END {print n" of "t}' /var/log/nginx/access.log
تفاوت ۵۰۲ با ۵۰۰ و ۵۰۳ و ۵۰۴
چهار کد ۵xx در یک نگاه شبیهاند و در عمل سه لایهٔ متفاوت را نشان میدهند. ۵۰۰ یعنی سرور درخواست را گرفت و اجرا شکست. ۵۰۲ یعنی واسط از بالادست پاسخ معتبر نگرفت. ۵۰۳ یعنی سرویس عمداً درخواست را رد میکند و میگوید بعداً بیا. ۵۰۴ یعنی واسط به بالادست وصل شد ولی پاسخ در زمان مقرر نیامد. تفاوت ۵۰۲ و ۵۰۴ فقط این است که اتصال برقرار شد یا نه — و همین یک تفاوت، مسیر عیبیابی را عوض میکند.
| کد | چه کسی میسازد | معنا | کِی میبینید |
|---|---|---|---|
| ۵۰۰ | PHP یا خود وردپرس | اجرا شکست؛ خطای مهلک یا حافظه | یک صفحهٔ خاص، معمولاً با پیام «critical error» |
| ۵۰۲ | واسط: nginx، CDN، پروکسی | پاسخ بالادست نامعتبر یا غایب | سوکت، ورکر، یا پاسخ نصفه |
| ۵۰۳ | خود سایت، عمداً | سرویس موقتاً در دسترس نیست | حالت نگهداری، بهروزرسانی، یا محدودیت نرخ |
| ۵۰۴ | واسط، بعد از اتصال | اتصال برقرار شد، پاسخ نیامد | تایماوت خواندن، کندی دیتابیس |
این تفکیک در عمل تصمیم میسازد. اگر ۵۰۳ میگیرید، دنبال فایل .maintenance و بهروزرسانی نیمهکاره بگردید؛ افزونهها مقصر نیستند. اگر ۵۰۴ میگیرید، تایماوتها و کوئری کند را بررسی کنید، چون اتصال برقرار شده و کسی جواب نداده. اگر ۵۰۲ میگیرید، اول باید بفهمید اتصال برقرار نشده یا پاسخ نامعتبر بود؛ بخش نگاشت errno همین را جواب میدهد. و اگر ۵۰۰ میگیرید، مسئله در کد است و لاگ PHP و فایل دیباگ وردپرس جای درست شروع است، نه لاگ nginx.
یک اشتباه رایج: وقتی سایت ۵۰۲ میدهد، بعضی افزونهها یا قالبها بهجای پیام روشن، صفحهٔ خطای خودشان را نشان میدهند و کد وضعیت را ۲۰۰ میکنند. در این حالت مرورگر ۲۰۰ میگیرد و شما فکر میکنید خطا رفع شده. همیشه کد وضعیت را از هدر بخوانید، نه از متن صفحه. همین قاعده در جهت مخالف هم صادق است: صفحهای که «خطای سرور» نشان میدهد ممکن است ۴۰۴ باشد. تفاوت ۵۰۰ و ۵۰۲ و ۵۰۳ در نحوهٔ خواندن لاگ آمده، ولی اگر میخواهید یکی از اینها را عمیقتر بخوانید، راهنمای خطای ۵۰۰ وردپرس از لاگ سرور تا افزونهٔ مقصر را جدا کرده، و کد ۵۰۳ و هدر Retry-After داستان خودش را دارد.
پیشگیری از ۵۰۲ در بار انبوه
هر ۵۰۲ای که در بار انبوه میآید، یک علت دارد که در حالت عادی پنهان است. سه علت تکرارشونده را بشناسید. اول، حلقهٔ wp-cron ورکرهای FPM را پر میکند: وردپرس با هر بازدید یک درخواست HTTP به خودش میزند تا کارهای زمانبندیشده را اجرا کند. زیر بار، همان درخواستها با ترافیک واقعی رقابت میکنند و استخر را پر میکنند. راهش خاموش کردن آن و استفاده از کران واقعی سیستم است.
// wp-config.php — قبل از خط «That's all, stop editing!»
define('DISABLE_WP_CRON', true);
# و در crontab سرور، هر پنج دقیقه یکبار:
*/5 * * * * cd /var/www/example.com/public_html && wp cron event run --due-now >/dev/null 2>&1
دوم، عملیات سنگین بدون محدودیت. پشتیبانگیری، بازسازی تصاویر، همگامسازی با سرویس بیرونی و گزارشهای بزرگ، همه در یک درخواست اجرا میشوند و همان یک درخواست چند ورکر را برای دقایق میبلعد. اگر پشتیبانگیری روی سرور خودتان انجام میشود، ساعت اجرای آن را به کمترافیکترین ساعت ببرید و در همان ساعت انتظار ۵۰۲ را داشته باشید. روشهای پشتیبانگیری و تنظیم زمانبندیشان در راهنمای پشتیبانگیری در وردپرس آمده است.
سوم، ناسازگاری نسخه. افزونهای که با PHP جدید تست نشده، در بار انبوه بیشتر از حالت عادی خودش را نشان میدهد؛ چون کدی که در یک درخواست کند است، در صد درخواست همزمان مخرب است. حداقل نسخههایی که وردپرس برای اجرا لازم دارد و تفاوت PHP 8.1 با 8.3 در مصرف حافظه، در راهنمای نیازمندیهای اساسی سرور برای وردپرس آمده است.
سه اقدام پیشگیرانه که واقعاً تفاوت میسازند: کش صفحه را در لبه یا در خود وردپرس روشن کنید تا درخواستهای تکراری به PHP نرسند. سقف pm.max_children را با حافظهٔ واقعی همتراز کنید، نه با عدد پیشفرض. و یک صفحهٔ ایستای سلامت بسازید که از PHP عبور نکند، تا وقتی همهچیز ۵۰۲ میشود بتوانید از بیرون بفهمید سرور زنده است یا نه.
و برای پایش، یک قاعدهٔ ساده: اگر ۵۰۲ در یک بازهٔ دهدقیقهای بیش از یک درصد درخواستها را گرفت، آن را حادثه بدانید نه نوسان. زیر یک درصد، احتمالاً یک کران سنگین یا یک درخواست خراب است. نسبت را از لاگ بگیرید و با تاریخ ثبت کنید؛ «دیروز کند بود» داده نیست.
پرسشهای متداول دربارهٔ خطای ۵۰۲
چرا خطای ۵۰۲ فقط بعضی وقتها میآید؟
چون به ظرفیت گره خورده است، نه به کد. اگر علت خطای مهلک در یک فایل بود، همیشه میآمد. ۵۰۲ پراکنده یعنی یا استخر ورکر در لحظهٔ پیک پر میشود، یا درخواستی وجود دارد که گاهی کند است — یک همگامسازی با API بیرونی، یک کوئری بدون ایندکس، یک کران سنگین. الگوی زمانی خطا را یادداشت کنید؛ اگر با ساعت پیک یا با یک عملیات مشخص همخوان بود، همان را پیدا کردهاید.
آیا خطای ۵۰۲ تقصیر وردپرس است؟
بهطور مستقیم نه. ۵۰۲ را PHP-FPM یا وبسرور میسازد، چون پاسخ معتبری نگرفتهاند. ولی دلیلِ نگرفتن پاسخ میتواند کد وردپرس، افزونه یا قالب باشد که ورکر را میکشد یا طولانی مشغول نگه میدارد. تفکیکش ساده است: اگر تست فایل ایستا سالم بود و slowlog نام یک افزونه را نشان داد، مقصر همان افزونه است. اگر slowlog خالی بود و errno 13 یا 2 دیدید، مقصر پیکربندی سرور است.
افزایش max_execution_time خطای ۵۰۲ را رفع میکند؟
بهتنهایی نه، و گاهی بدتر میکند. اگر مسئله صف پر باشد، سقف بزرگتر یعنی هر ورکر بیشتر اشغال میماند و صف طولانیتر میشود. این تنظیم فقط وقتی مؤثر است که یک اسکریپت مشخص واقعاً به زمان بیشتری نیاز داشته باشد و ظرفیت استخر هم کافی باشد. ترتیب درست سه عدد — سقف nginx، سقف PHP-FPM، و سقف PHP — را در بخش تنظیم upstream دیدید؛ تغییر یکی بدون دیگری خطا را از ۵۰۲ به ۵۰۴ یا به ۵۰۳ منتقل میکند، نه حل.
بعد از انتقال هاست چرا ۵۰۲ میگیرم؟
چون یکی از سه چیز در مقصد با مبدأ فرق دارد: نسخهٔ PHP، مسیر سوکت PHP-FPM، یا پیکربندی وبسرور. متداولترین حالت این است که fastcgi_pass هنوز به سوکت نسخهٔ قبلی اشاره میکند و آن فایل در مقصد وجود ندارد — همان errno 2. حالت دوم، سختتر شدن مجوز سوکت است (errno 13)، و حالت سوم، جا ماندن یک دستور Apache در پیکربندی مقصد است. اول لاگ را بخوانید؛ عدد داخل پرانتز مقصد را مشخص میکند.
چه اطلاعاتی به میزبان بدهم تا سریع حل شود؟
پنج قلم، بدون تفسیر. زمان دقیق با منطقهٔ زمانی، آدرس کاملی که خطا داد، کد وضعیت و نام سرور از هدر پاسخ، یک ردیف کامل از لاگ خطا با همان زمان، و اینکه خطا در همهٔ صفحهها هست یا فقط در صفحههای PHP. اگر پشت CDN هستید، شناسهٔ Ray ID را هم اضافه کنید. با این پنج قلم، پاسخ معمولاً در همان تیکت اول میآید؛ بدون آنها، رفتوبرگشت شروع میشود.